



 人民網+
 中國共產黨新聞網
 領導留言板
 強國論壇
 人民視頻
國產大模型引領全球開源生態(大數據觀察·智能經濟新形態)
累計下載量突破100億次
 222
 訂閱已訂閱已收藏
 收藏
 小字號
點擊播報本文,約

 |
數據來源:工業和信息化部 |
近日,北京月之暗面科技股份有限公司公布了Kimi K3.1 Pro完整模型權重,這款全球參數規模最大開源模型在技術社區引發了廣泛討論﹔騰訊混元發布了新一代大語言模型Hy4,在指令遵循、長文理解、長程任務及深度研究等能力方面實現了提升。
前不久閉幕的2026年世界互聯網大會烏鎮峰會上,“開源”也成為關鍵詞。今年以來,我國多家科技企業密集推出開源模型產品,在參數規模與技術深度方面不斷實現突破。什麼是開源?如何看待模型開源現象?國產開源模型有哪些新的發展趨勢?
開源步伐加快,下載量、衍生模型數量領跑
與軟件“公開源代碼”的字面意義不同,模型開源更多指的是“開放權重”。
簡單來說,模型就像是一個擁有海量知識的大腦,而“權重”就是這個大腦中數以千億計的參數數值。這些參數記錄了模型在訓練過程中學到的所有語言規律、邏輯推理能力和各種知識。
“開放權重”,意味著使用者可以下載模型,在自己的電腦或服務器上運行推理,甚至通過微調讓它來適應特定的任務。例如,企業和開發者不需要花費大筆資金從頭開始訓練,就能獲得一個極其聰明的模型底座﹔它還允許在本地服務器或私有雲上部署,這對一些對數據隱私要求極高的用戶來說很關鍵。日益豐富的開源模型,還能讓發展中國家以低成本獲取前沿能力。
不過,開源不等同於放棄商業回報,依托雲端推理、智能體平台、模型微調等,企業依然能夠形成可持續的收益模式。
目前,我國日均詞元調用量已突破500萬億,國內網購平台已上線詞元充值中心,“雙11”直播間裡,詞元也成了搶手貨。“詞元可計量、可定價、可交易的屬性逐步被挖掘,詞元調用量正成為觀察人工智能(AI)活躍度、產業滲透深度、智能化發展水平的重要指標。”中央網信辦副主任王京濤表示。
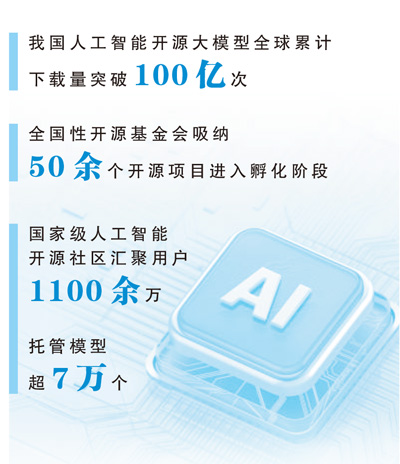
在高度市場化的模型聚合平台上,中國開源模型的表現同樣突出。11月9日至15日,全球開源模型聚合平台OpenRouter上中國模型的周調用量為119.1萬億詞元,連續29周穩居全球首位。工業和信息化部數據顯示,我國人工智能開源大模型全球累計下載量突破100億次。“一批全球領先的開源模型持續涌現,下載量、衍生模型數量領跑,引領全球人工智能開源生態。”中國科學技術信息研究所黨委書記黃琦說。
競爭力提升,模型架構加快創新、底層技術不斷突破
國產開源模型競爭力的提升,不僅源於應用范圍廣,更來自模型架構加快創新、底層技術不斷突破。
去年年初,深度求索發布的DeepSeek系列模型,不僅在性能上取得了突破,更對混合專家模型架構進行了創新,大幅降低了推理成本和算力需求。這種架構后來成為全球人工智能領域共同探索的方向。
今年發布的Kimi K3則提出了自主研發的混合線性注意力機制等,讓“超長文本算得更省,超大模型訓得更穩”。“我們從底層邏輯對該架構的關鍵組件進行了重構,讓模型訓練找到全新進化空間。”月之暗面Kimi創始人兼首席執行官楊植麟說,中國開源模型正在成為全球模型廠商評測中的標杆和海外研究機構的重要樣本。
國產開源模型與國產算力適配度的提升同樣值得關注。今年6月,美團發布依靠國產算力完成訓練、推理全流程的萬億參數大模型。11月,美團新一代大模型LongCat—2.5發布,推動國產算力上的大模型從“跑得動”走向“跑得快、跑得省”。美團龍貓大模型負責人蔡勛梁說:“我們逐步攻克了神經網絡處理器確定性計算、算力利用率提升等難題,驗証了大規模國產訓練的可行性。”
為了推動人工智能落地,國內芯片廠商也在產品設計上持續進行優化。“國產開源模型能力提升,帶動智能體、編程、視頻生成等需求提速,將催生大量長上下文承載、多輪工具的高頻調用,以及更高效的多模態並發處理能力。調用規模越大,用戶對響應速度、使用成本就越敏感。”國產推理GPU(圖形處理器)廠商曦望董事長徐冰說。
應用深度增強,推動智能成果普惠全球
隨著技術的發展,國產開源模型正走入更多應用場景。
深夜的京東方生產線上,顯示面板有序通過各道工序。人工智能系統實時捕捉到一處微觀缺陷,即刻生成修復方案,聯動設備完成修復——從發現問題、分析判斷,到執行處理,實現全鏈路智能化質量管理閉環。
“我們以國產開源大模型為基礎底座,自主研發了京東方藍鯨顯示大模型,融合工業制造經驗和產線數據,覆蓋研發設計、生產制造、質量管理等場景,推動多項AI應用在京東方各地工廠落地。”京東方高級副總裁、聯席首席技術官姜幸群說。
個人開發者吳瑞孟接到一名淘寶店主“用二次元圖片給車貼膜”的需求時,馬上聯想到“AI試衣”場景。他在無代碼應用開發平台“秒噠”上,隻花了25分鐘就設計出demo(小樣),這個“+AI”的創意,最終以8000元的價格成交。“用自然語言描述需求,由模型創建定制化應用,人工智能可以幫我補齊能力短板。”吳瑞孟表示。
中國開源模型同樣改變著海外用戶的工作方式和海外企業的成本結構。
去年底,一款名為“海獅V4”的多語言大模型在新加坡發布。該模型以阿裡千問開源模型為基座研發,聚焦東南亞復雜的語言使用環境,受到當地用戶的歡迎。“海獅V4”依托千問開源模型覆蓋119種語言的優勢,在36萬億詞元上進行了預訓練。在新加坡人工智能計劃高級總監劉思理看來,與中國企業的合作是推動AI普惠化、使其更具東南亞代表性的一個重要標志。
“人工智能普惠的可能性,需要建立在堅實的開源根基上。”中國科學院計算技術研究所研究員張雲泉表示,從技術、規則到公共產品,中國正把普惠的願景轉化為實實在在的行動。
《 人民日報 》( 2026年11月21日 05 版)
 關注公眾號:人民網財經
分享讓更多人看到 
 人民日報
 人民日報少年
 人民網+
 手機人民網
 領導留言板
 人民視頻
 人民智作
 微信掃一掃
人民日報社概況| 關於人民網| 報社招聘| 招聘英才| 廣告服務| 運營服務| 合作加盟| 版權服務| 數據服務| 網站聲明| 網站律師| 信息保護| 聯系我們
人民日報違法和不良信息舉報電話:010-65363263 舉報郵箱:jubao@people.cn
人民網服務郵箱:kf@people.cn 違法和不良信息舉報電話:010-65363636 舉報郵箱:rmwjubao@people.cn
互聯網新聞信息服務許可証10120170001 | 增值電信業務經營許可証B1-20060139 | 廣播電視節目制作經營許可証(廣媒)字第172號 | 京ICP備12004265號-13
信息網絡傳播視聽節目許可証0104065 | 網絡文化經營許可証 京網文[2023]4961-141號 | 網絡出版服務許可証(京)字121號 | 京ICP証000006號 | 京公網安備11000002000008號
人 民 網 股 份 有 限 公 司 版 權 所 有 ,未 經 書 面 授 權 禁 止 使 用
Copyright © 1997-2026 by www.people.com.cn. all rights reserved
-
評論

-
關注
微信微博快手
 第一時間為您推送權威資訊
 報道全球 傳播中國
 關注人民網,傳播正能量


